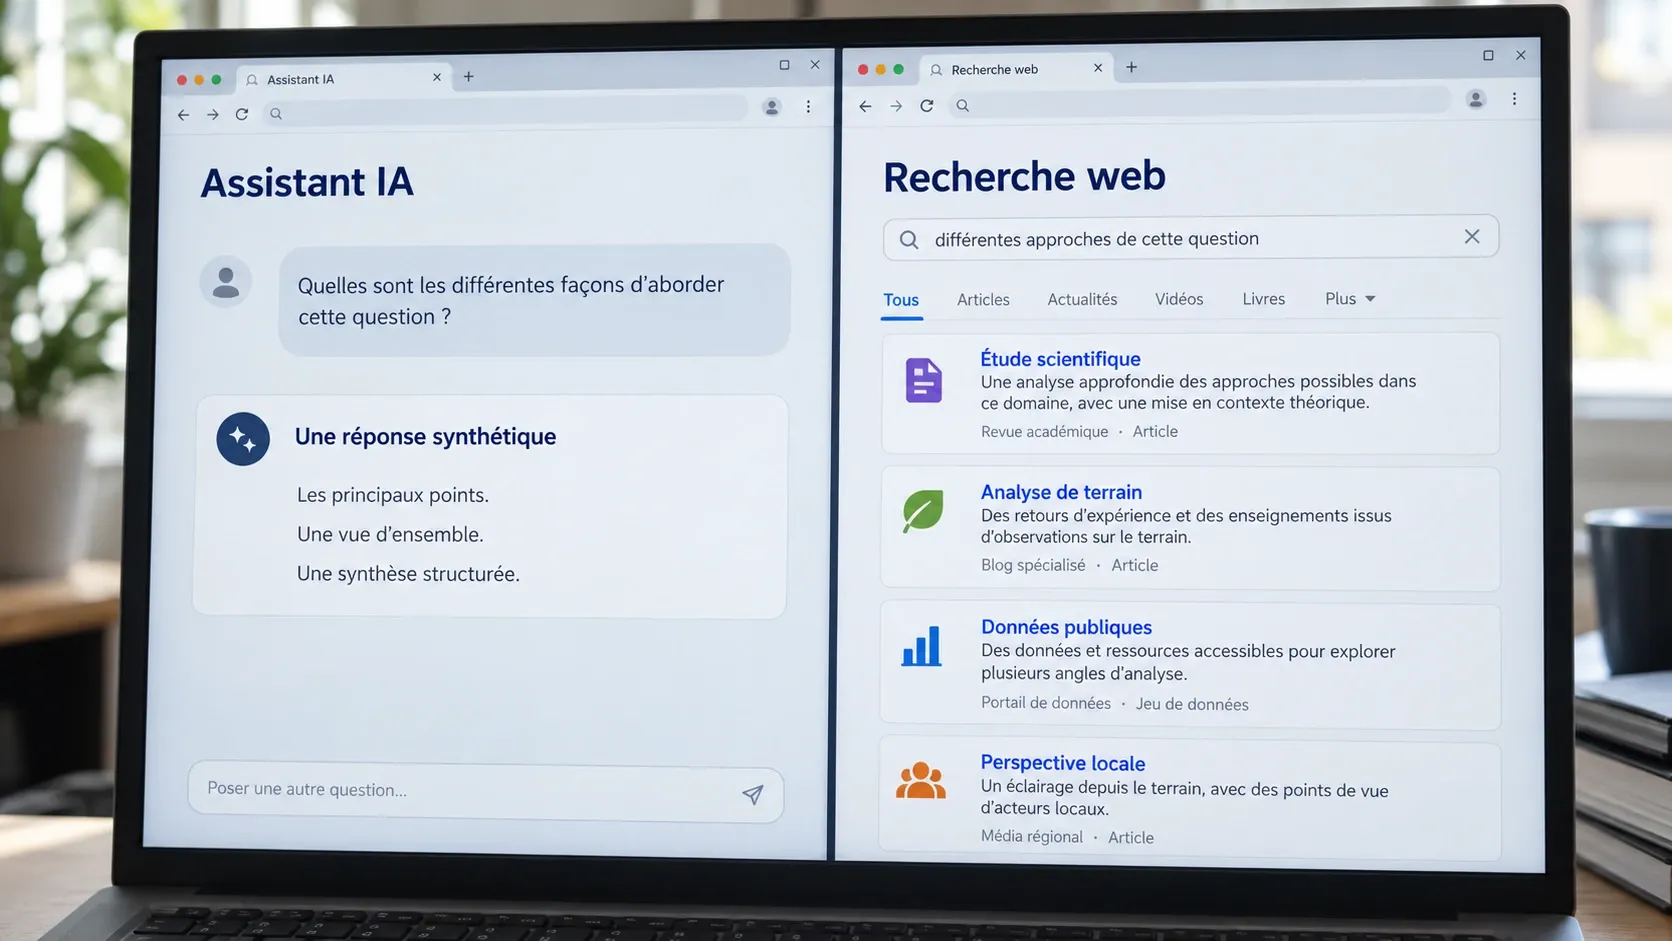
Une réponse peut être juste, claire et longue tout en donnant accès à un éventail étroit d'informations. Une étude menée sur 27 modèles propose de mesurer cette diversité épistémique comme une qualité à part entière. Ses résultats montrent un écart avec la recherche web, mais aussi des progrès récents et une piste d'amélioration conditionnelle : la récupération de documents.
Un assistant répond. Un moteur de recherche expose des documents. Cette différence d'interface semble surtout opposer la commodité d'une synthèse au travail de consultation des liens. Elle cache pourtant une question plus profonde : combien d'affirmations distinctes et de manières de décrire un sujet chacune de ces interfaces rend-elle accessibles ?
L'exactitude ne suffit pas à répondre. Deux systèmes peuvent produire des phrases également vraies, mais l'un répéter quelques faits dominants quand l'autre fait émerger des éléments plus rares, des contextes locaux ou des désaccords documentés. La longueur ne suffit pas davantage : une réponse développée peut reformuler plusieurs fois le même noyau d'information.
C'est cette dimension que les auteurs de l'étude What and Whose Knowledge? Measuring Epistemic Diversity in Large Language Models appellent la diversité épistémique. Leur travail, accepté à EMNLP 2026 et présenté par l'Université de Copenhague le 26 septembre, ne cherche pas à savoir seulement si un modèle se trompe. Il mesure la variété des affirmations qu'il peut faire apparaître.
Mesurer autre chose que la vérité d'une réponse
Le protocole est vaste : 27 systèmes issus des familles Llama, Gemma, Qwen et OpenAI, 155 sujets liés à 12 pays et 200 formulations de prompt par sujet. Les chercheurs ont recueilli environ 1,7 million de réponses, puis les ont décomposées en quelque 70 millions d'affirmations.
Ils ont ensuite regroupé les affirmations jugées sémantiquement équivalentes. « La liberté d'expression est essentielle au fonctionnement de la démocratie » et une paraphrase de cette proposition appartiennent ainsi à la même classe de sens. La distribution de ces classes sert à calculer un indice de diversité : plus un système fait émerger de classes distinctes, sans se concentrer toujours sur les mêmes, plus son score est élevé.
Ce calcul porte donc sur un ensemble de réponses et de formulations, pas sur le nombre de phrases d'une réponse isolée. Il ne mesure ni directement la véracité, ni l'utilité, ni la pertinence. Il ajoute une question à ces critères : quelles parties du savoir disponible restent hors champ, même lorsque ce qui est dit est correct ?
Pour construire une référence, les auteurs ont récupéré jusqu'aux 40 premiers résultats Google pour chaque sujet, à partir d'une requête réduite au nom du sujet. Dans ce cadre précis, tous les systèmes testés produisent des ensembles d'affirmations moins diversifiés que la recherche. Même GPT-5, le meilleur modèle de l'échantillon sur ce critère, obtient un score moyen de 2 621 contre 3 110 pour la référence web. Les auteurs expriment cet écart comme une recherche au moins 18,7% plus diverse sur les sujets étudiés.
Ce résultat ne signifie pas que Google serait intrinsèquement plus divers, ni qu'un utilisateur lirait effectivement 40 pages. Il compare deux distributions d'affirmations dans un protocole donné. Le moteur rend disponibles plusieurs documents ; l'assistant condense ce qu'il sélectionne dans une réponse. Une URL trouvée n'est pas encore une information lue, comprise ou utilisée.
La synthèse réduit aussi l'espace visible
Un LLM génère la suite de texte la plus plausible au regard de sa question, de ses paramètres et du contexte qui lui est fourni. Cette capacité produit des synthèses remarquablement fluides. Elle favorise aussi les associations les plus stables et les formulations les plus probables. Interroger plusieurs fois le même modèle peut alors faire revenir un socle proche de faits, même si les phrases changent.
La recherche web conserve davantage de friction, mais cette friction a une fonction. Plusieurs pages peuvent jouer des rôles différents : un comparatif fait découvrir des options, une documentation officielle confirme une spécification, un média sectoriel replace une annonce dans son marché, un forum rend visibles des problèmes d'usage. Leur valeur ne se résume pas à une hiérarchie unique. Une source institutionnelle peut faire autorité pour vérifier un agrément sans être la meilleure source pour comprendre une irritation quotidienne.
Chez Maple Labs, nous distinguons ainsi les sources qui font découvrir une option de celles qui apportent la couverture nécessaire pour la qualifier et la comparer. Une même page peut remplir les deux rôles, mais son statut ne se déduit ni de son prestige ni de sa simple présence dans les résultats. Il faut observer ce que l'assistant en fait. Cette distinction devient décisive lorsque la synthèse masque le parcours documentaire qui l'a précédée.
Les modèles progressent, l'effondrement n'est pas constaté
Le titre le plus spectaculaire serait celui d'un « effondrement des connaissances ». L'étude ne l'établit pas. Au contraire, les auteurs observent une hausse substantielle de la diversité épistémique au fil des générations de modèles étudiées. Gemma 3 et GPT-5 enregistrent notamment les plus fortes progressions entre deux générations dans leur échantillon.
Le risque décrit est celui d'une boucle future : si des modèles produisent des sorties homogènes, puis que ces textes dominent les corpus utilisés par les systèmes suivants, la variété disponible pourrait se contracter. Mais la composition des corpus propriétaires récents reste partiellement inconnue, et l'étude ne suit pas cette chaîne d'entraînement au fil du temps. Elle mesure les sorties de modèles existants. Parler d'un effondrement déjà réalisé transformerait donc une hypothèse de risque en fait acquis.
Un autre résultat invite à résister aux raccourcis. Dans ce protocole, les grands modèles sont moins diversifiés que les plus petits. Les chercheurs avancent une capacité accrue à mémoriser comme explication possible, sans démontrer que ce mécanisme est la cause de l'écart. Une meilleure performance générale ne garantit simplement pas une meilleure diversité sur cette mesure.
La géographie révèle aussi une asymétrie. Pour des sujets associés à plusieurs pays, les affirmations des modèles anglophones correspondent davantage aux pages Wikipédia en anglais qu'aux pages en langue locale. L'écart est statistiquement significatif dans cinq des huit pays comparés ; dans aucun cas la représentation locale ne dépasse significativement l'anglaise. Ici encore, il s'agit d'un test circonscrit à des sujets, des langues et des sources de comparaison déterminés, mais il montre ce qu'une moyenne globale peut cacher.
La récupération documentaire aide si son corpus est divers
Les chercheurs ont également testé la génération augmentée par récupération, ou RAG. Avant de répondre, le système reçoit des passages sélectionnés dans un corpus documentaire. Dans l'expérience, ces passages proviennent des 20 premiers résultats de recherche par sujet et sont choisis selon leur proximité avec le prompt.
Le RAG augmente significativement la diversité par rapport à la seule connaissance paramétrique des modèles. Il ne rejoint toutefois pas, en moyenne, la référence constituée par les pages de recherche. Surtout, son effet varie selon les pays. Plus les documents récupérés pour un groupe de sujets sont eux-mêmes diversifiés, plus le gain en sortie est important.
La récupération ne crée donc pas mécaniquement de pluralité. Elle transmet en partie la structure de son corpus : ses langues, ses absences, ses redondances et ses choix de classement. Dans cette étude, la recherche documentaire a été effectuée depuis une région américaine, ce qui peut défavoriser certaines sources locales. Une base riche en textes presque identiques offrira peu de diversité, même avec une excellente mécanique de récupération.
Cette distinction évite aussi de confondre recherche et entraînement. Une page consultée pendant une interaction peut élargir la réponse du moment. Cela ne prouve ni qu'elle figurait dans les données d'entraînement, ni qu'elle influencera un futur modèle.
Ce que les responsables de contenus devraient regarder
Pour une organisation, être mentionnée dans une réponse n'épuise pas la question. Il faut aussi comprendre dans quel paysage documentaire l'assistant la situe. Trois contrôles deviennent utiles :
- Observer le parcours, pas seulement la réponse finale. Quelles requêtes sont lancées, quels domaines apparaissent, quelles pages sont ouvertes et quelles informations sont effectivement mobilisées ?
- Vérifier la complémentarité des sources. Les contenus disponibles couvrent-ils les preuves officielles, les critères de comparaison, les retours d'usage et les contextes locaux, ou répètent-ils tous le même message ?
- Comparer les formulations et les systèmes. Une réponse unique peut sembler complète. La répétition des mêmes affirmations à travers plusieurs prompts révèle mieux ce qui reste invisible.
Ces contrôles ne permettent pas de promettre qu'une publication entraînera une recommandation. Ils servent à distinguer une présence apparente d'une couverture réellement utilisable par l'assistant, puis à mesurer l'effet dans les recherches et réponses observées.
Un résultat important, dans un périmètre précis
Les auteurs détaillent plusieurs limites. Les 155 sujets mêlent sélection aléatoire et choix manuel ; le recours à des pages Wikipédia notées au moins C écarte des thèmes très spécialisés. La décomposition des réponses et le regroupement sémantique comportent du bruit, avec une définition volontairement stricte de l'équivalence. Le RAG simule une architecture parmi beaucoup d'autres. Enfin, les 40 résultats Google constituent une référence limitée, datée et régionale, pas une mesure universelle du web.
La diversité épistémique n'est donc pas un nouveau score total de qualité. Davantage d'affirmations peut aussi introduire du faux, du hors-sujet ou du bruit. Mais ignorer cette dimension revient à confondre une bonne réponse avec une vue suffisamment large du problème.
À mesure que les assistants deviennent une porte d'entrée vers l'information, leur qualité se jouera aussi dans ce qu'ils rendent possible de voir. Une réponse exacte peut clore une question. Un système véritablement informatif doit parfois laisser apparaître qu'il existe plusieurs chemins pour y répondre.